 senn-tech
Migration von VMware zu Proxmox
Referenzkunde: Logistik- und Handelsgruppe in Tirol · ~100 Mitarbeiter · 4 Standorte
Kundendaten in Texten und Bildern sind neutralisiert.
Ausgangslage
Die Virtualisierung lief seit Jahren auf VMware, bis die neue Lizenzpolitik die Kosten in eine Höhe trieb, die für einen Mittelständler nicht mehr zu rechtfertigen war. Dazu die Abhängigkeit: proprietärer Storage, proprietäres Management, kein einfacher Weg hinaus.
Gesucht war der Ausstieg: ohne Big Bang, ohne Wochenend-Ausfälle, und mit einer Hochverfügbarkeit, die den Namen verdient.
Das Schwierige daran
Eine virtuelle Maschine umzuwandeln dauert Minuten. Was Planung kostet, ist die Reihenfolge: Ein Dienst, dessen Datenbank schon umgezogen ist, dessen Anwendung aber noch drüben läuft, ist kein halber Umzug; er ist ein Ausfall. Vor dem ersten Umzug stand deshalb eine Abhängigkeitsliste, und migriert wurde entlang dieser Liste und nicht nach Bequemlichkeit.
Die eigentliche Entscheidung war aber nie der Hypervisor. Der ist austauschbar. Entschieden wird ein solches Vorhaben am Speicher, und dort standen fünf ernsthafte Wege zur Auswahl, die wir der Reihe nach durchgerechnet statt diskutiert haben.
Ein zentraler Speicherserver mit ZFS, angebunden über iSCSI, ist der naheliegendste Weg und war der erste, der ausschied: Die Anbindung kennt nur einen Kopf. Eine Kiste besitzt jedes Laufwerk und ist damit der einzelne Ausfallpunkt für beide Standorte. Genau das Ziel, für das der ganze Aufbau existiert, wäre damit gestrichen. Zwei gewöhnliche Knoten lassen sich auch nicht zu einem hochverfügbaren Paar erklären: Dafür braucht es eine Doppelkopf-Hardware mit gemeinsamer Rückwand und nicht zwei Server mit internen Datenträgern.
Zwei gespiegelte Speicherserver hätten funktioniert, und sind bei näherem Hinsehen dasselbe, was schon läuft, nur auf zusätzliche Geräte verschoben und mit einem zusätzlichen Netzweg dazwischen. Das ist der Punkt, an dem der Vergleich unerwartet wurde: Zwei gespiegelte Speicherserver und eine Umstellung der lokalen Plattenverwaltung von Spiegelung auf Parität bringen denselben Platzgewinn von rund einem Drittel. Weil es dieselbe Geometrie ist: Parität lokal, zwei Kopien über die Standorte. Der eine Weg kostet einen Speicherserver und eine neue Fehlerquelle, der andere ist ein Umbau auf Platten, die längst im Haus sind.
Ceph ist der Name, den in solchen Gesprächen immer jemand nennt. Über zwei Standorte betrieben braucht es vier Kopien plus einen Schiedsrichter, und die Speichereffizienz ist damit identisch zu heute, der Platzgewinn also null. Und die Latenz entscheidet dagegen: Auf unserer eigenen Datenbanklast gerechnet landet es 40 bis 90 Prozent langsamer. Sechs Knoten sind für Ceph außerdem klein; ein Knoten ist ein Sechstel des Clusters, und eine Wiederherstellung trifft entsprechend hart.
Vitastor war der ehrlichste Fall, weil fast alles dafür sprach. Gemessen ist es gleich schnell. Die verbreitete Behauptung, es sei doppelt so langsam, hält der Messung nicht stand. Der Platzbedarf ist ebenfalls gleich. Und es hat sogar die bessere Aufstellung: vier unabhängige Kopien auf vier Wirten überstehen einen Standortausfall und anschließend noch einen Knotenausfall, während zwei Kopien mit Schiedsrichter nach einem Standortausfall genau eine Kopie übrig lassen, ohne jede Reserve. Ausgeschieden ist es am Ende an einer einzigen Achse: dem Vertrauen in den Schreibpfad. Das ist kein Urteil über das Projekt, vielmehr eine Aussage über die Frage, wo wir eine Wette eingehen wollen und wo nicht.
Der zweite Standort ist der Grund, warum die Rechnung so ausgeht. Die Knoten sind absichtlich verschränkt verteilt statt blockweise. Dadurch übersteht der Cluster den Ausfall eines ganzen Brandabschnitts. Der Preis ist eine Regel, die man kennen muss: Zwei Knoten dürfen nur dann gleichzeitig neu starten, wenn sie am selben Standort stehen. Wer nach Nummern statt nach Standort vorgeht, nimmt beiden Seiten eines Paares gleichzeitig die Grundlage.
Lösung
Migriert wurde auf einen Proxmox-Cluster mit sechs Knoten, verteilt auf zwei Brandabschnitte. Der Storage repliziert synchron über DRBD/LINSTOR auf dedizierten 100-Gigabit-Links. Fällt ein Knoten oder ein ganzer Standort aus, starten die Maschinen auf der anderen Seite weiter.
Die rund 60 produktiven VMs zogen im laufenden Betrieb um, Dienst für Dienst, mit Rollback-Pfad. Heute laufen über 300 replizierte Storage-Ressourcen im Cluster, nächtlich per Checksummen-Verify auf stille Datenfehler geprüft.
Überwacht wird der Cluster vom hauseigenen SIEM, von der NVMe-Ebene bis ins Gast-Dateisystem.
Wie es gebaut ist
Sechs Knoten, zwei Brandabschnitte, verschränkt verteilt. Der Speicher repliziert synchron zwischen Knotenpaaren über ein eigenes 100-Gigabit-Netz, das vom Nutzdatenverkehr vollständig getrennt ist. Replikation und Anwendungslast konkurrieren nie um dieselbe Leitung. Über 300 replizierte Speicherressourcen tragen die produktiven Maschinen.
Auf dieser Grundlage liegt die eigentliche Hochverfügbarkeit: Rund 57 virtuelle Maschinen stehen unter Verwaltung des Cluster-Managers. Nicht eine Handvoll als wichtig markierter, vielmehr praktisch der gesamte produktive Bestand. Jede trägt eigene Grenzen für Neustart- und Verlagerungsversuche; wird eine Maschine wiederholt nicht gesund, hört der Cluster auf, es zu versuchen, statt in eine Endlosschleife zu laufen.
Platziert wird nach Regeln und nicht von Hand. Knoten-Affinitäten binden jede Maschinengruppe strikt an genau das Knotenpaar, das ihre Daten physisch hält. Ohne diese Regel dürfte der Verteiler eine Maschine auf einen Knoten legen, auf dem ihr Datenträger nur über das Netz erreichbar wäre. Das läuft, kostet aber jeden Lesezugriff einen Netzweg. Die Regel macht aus einer funktionierenden Platzierung eine richtige.
Die zweite Regelart ist die, an der sich echte von nomineller Redundanz unterscheidet: negative Affinitäten. Die beiden Namensserver, die beiden Verzeichnisdienste und die beiden Reverse-Proxys sind jeweils als Paar erklärt, das niemals auf demselben Knoten laufen darf. Zwei DNS-Server auf einer Maschine sind kein zweiter DNS-Server; sie sind zwei Prozesse mit einem gemeinsamen Ausfall.
Für die Wartung ist hinterlegt, dass ein herunterfahrender Knoten seine Maschinen verlagert statt sie zu stoppen. Ein Knoten räumt sich damit selbst leer, bevor er geht. Die Verlagerung läuft über dasselbe getrennte Fabric wie die Replikation und ist dort bewusst unverschlüsselt, denn die Leitung ist privat, und die eingesparte Verschlüsselung ist genau der Unterschied zwischen einer Verlagerung in Minuten und einer in einer Viertelstunde.
Gesichert wird auf einen eigenen Backup-Server mit Deduplizierung und geprüften Wiederherstellungspunkten. Der Cluster ist an das hauseigene SIEM angebunden, von der Abnutzung der Datenträger bis zum Dateisystem im Gast.
Im Betrieb
Knoten werden einzeln aktualisiert, und weil die Wartungsregel die Maschinen verlagert statt sie zu stoppen, ist der Ablauf unspektakulär: Knoten leerräumen lassen, aktualisieren, zurückholen, Replikation abwarten, erst dann der nächste. Das dauert länger als ein gemeinsamer Neustart und ist der Grund, warum Updates hier kein Ereignis mehr sind.
Der Cluster bewertet seine eigene Verteilung fortlaufend und weist ein Ungleichgewicht als Zahl aus. Im Normalbetrieb steht sie auf null. Das ist die Kennzahl, an der man erkennt, ob eine Verlagerung nach einem Ausfall wieder aufgeräumt wurde oder ob eine Maschine dort stehen geblieben ist, wo die Störung sie hingeworfen hat.
Jede Nacht prüft ein Verify-Lauf die abgelegten Daten über Prüfsummen gegen stille Verfälschung: den Fehlertyp, den kein Dienst bemerkt, weil nichts abstürzt und die Datei sich lesen lässt.
Wiederherstellungen werden geübt und nicht angenommen. Eine Sicherung, aus der noch nie jemand etwas zurückgeholt hat, ist eine Vermutung.
Ergebnis
Die wiederkehrenden Virtualisierungs-Lizenzkosten sind auf null. Die Hardware gehört dem Unternehmen, der Stack ist offen, kein Vendor-Lock-in mehr.
Praktisch der gesamte produktive Bestand läuft unter Hochverfügbarkeit, und die Platzierung ist als Regel hinterlegt statt als Wissen im Kopf einer Person. Der Ausfall eines Knotens ist damit ein Vorgang, den der Cluster selbst abarbeitet, und der Ausfall eines ganzen Standorts einer, den die andere Seite trägt.
Knoten-Updates sind vom Wochenendtermin zur Routine geworden: Der Knoten räumt sich leer, wird aktualisiert und holt seine Maschinen zurück. Verfügbarkeitsziel 99,9 Prozent, ohne dass dafür jemand nachts arbeiten muss.
Was wir daraus gelernt haben
Die Zahl, die die ganze Entscheidung gedreht hat, war nicht die Speicherlatenz, vielmehr ihr Anteil. Ein Datenbankvorgang dauert bei uns rund zwei Millisekunden; davon entfallen etwa 0,15 auf den Speicher und der Rest auf Datenbankmaschine, Transaktion und Netzweg. Ein Speicher, der doppelt so schnell ist, verbessert damit nichts Messbares, und einer, der zehnmal langsamer ist, wird sofort sichtbar. Wer Schichten einzeln vergleicht, vergleicht Zahlen, die beim Anwender nie ankommen. Gemessen wird auf Anwendungsebene, sonst gewinnt regelmäßig die falsche Option.
Die gefährlichste Einstellung im ganzen Aufbau steht in der Voreinstellung und heißt: Was tut ein Knoten, wenn er die Mehrheit verliert? Standardmäßig meldet der virtuelle Datenträger einen Fehler. Das Gastsystem schaltet daraufhin sein Dateisystem auf Nur-Lesen und ist damit auch dann noch kaputt, wenn das Netz nach zwanzig Sekunden zurückkommt. Sinnvoller ist Anhalten statt Fehler melden: Die Maschine wartet und läuft weiter, sobald wieder Mehrheit besteht. Aber auch das ist kein Gratisgewinn: bei dauerhaftem Mehrheitsverlust hängt die Ein-/Ausgabe dann unbegrenzt. Richtig ist es nur zusammen mit einem Alarm darauf.
Es gibt einen Befehl, der eine auseinandergelaufene Replikation wieder in Gleichlauf bringt, indem er eine der beiden Seiten für ungültig erklärt. Er steht bei uns auf der Verbotsliste. Nicht weil er nicht funktioniert, vielmehr weil man in genau dem Moment nach ihm greift, in dem man unter Druck steht, und dann mit derselben Wahrscheinlichkeit die gute Seite verwirft.
Prüfen und Reparieren sind zwei Vorgänge, und ihre Reihenfolge ist keine Geschmacksfrage. Ein automatischer Reparaturlauf kann genau den Befund überschreiben, den die Prüfung in der Nacht davor gefunden hat, und hinterlässt einen Cluster, der sauber aussieht, weil der Beweis weg ist. Reparieren darf erst laufen, nachdem jemand den Befund gelesen hat.
Und der Satz, der am Ende über der ganzen Prüfung stand: Jedes gefundene Problem war eine Einstellung in der bestehenden Lösung, keine Eigenschaft von ihr. Das ist der häufigste teure Irrtum in der Infrastruktur: ein Produkt zu tauschen, weil es falsch konfiguriert ist. Der Tausch nimmt die alten Fehler mit und bringt neue, unbekannte dazu.
Andere Projekte aus dem Betrieb
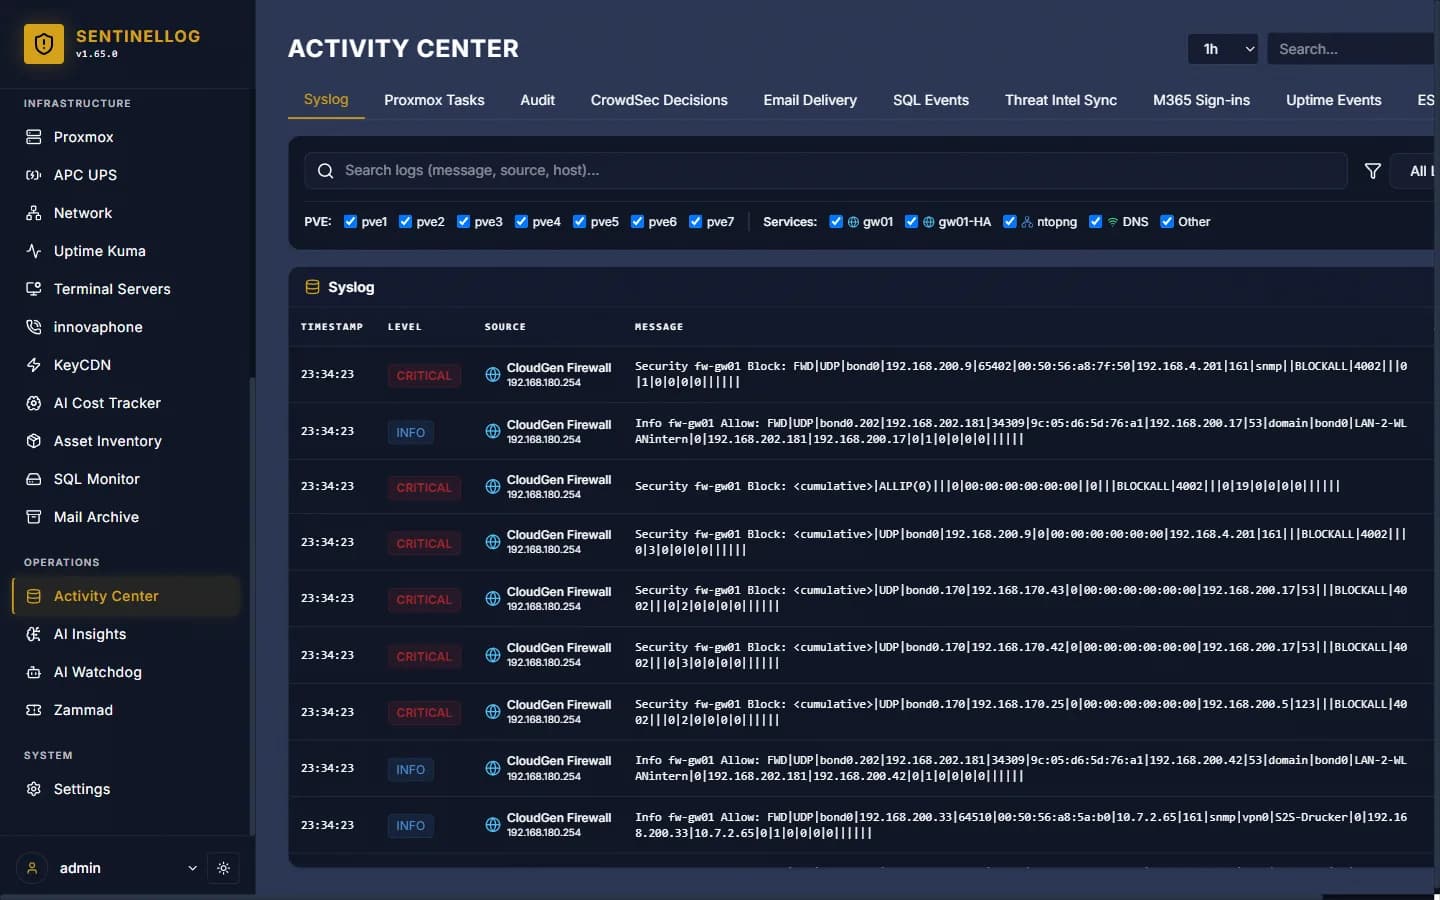
SIEM & Security-Monitoring mit Echtzeit-Korrelation
Logs aus der ganzen Firma an einem Ort, und nur die Alarme, die zählen.
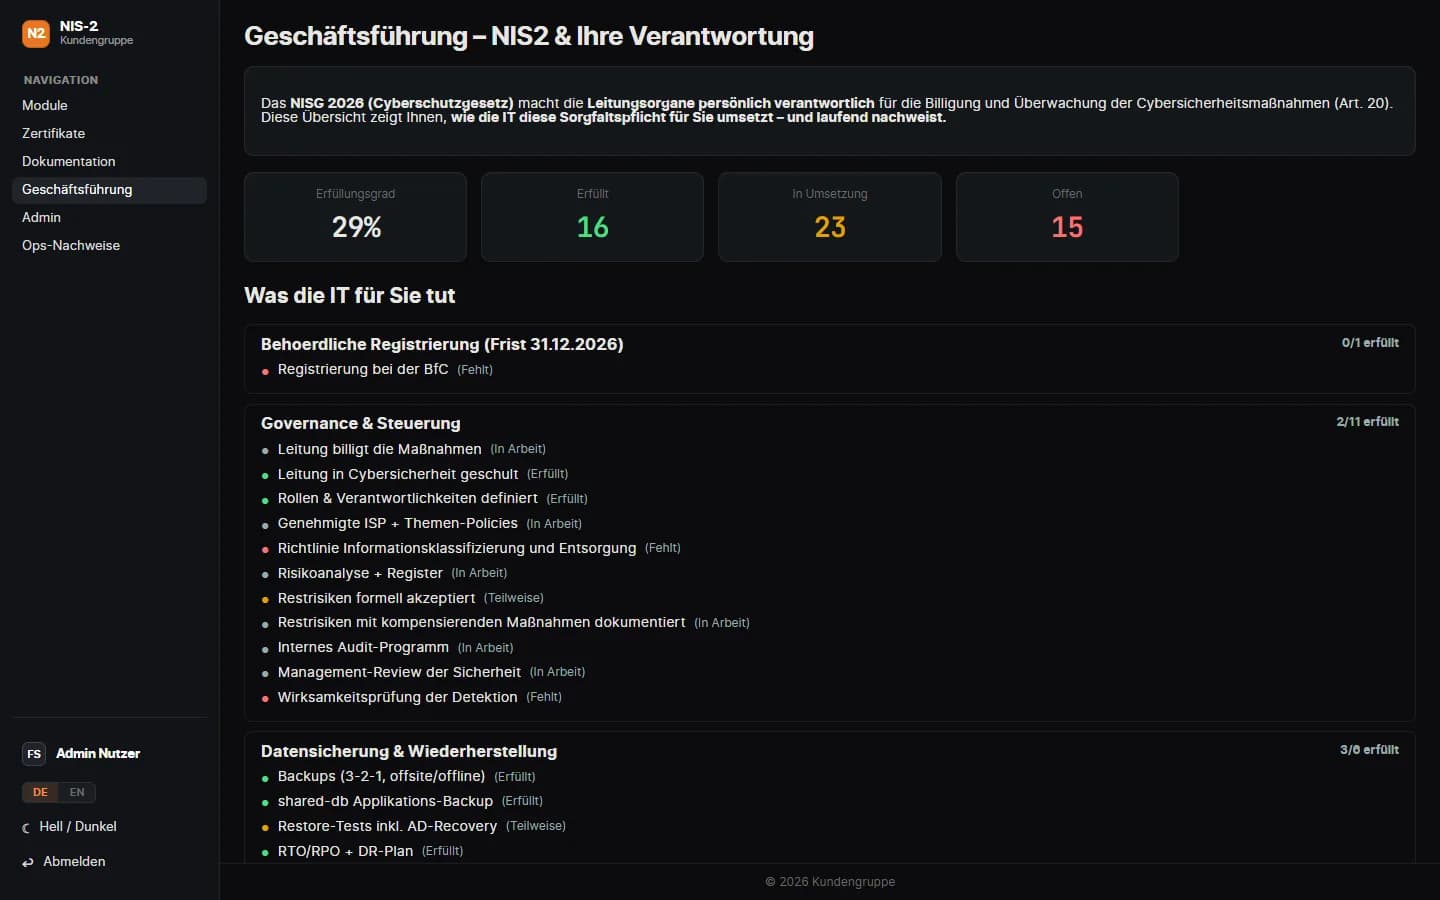
NIS2-Compliance-Plattform
55 Kontrollen, klare Verantwortliche, automatische Erinnerungen: Compliance als laufender Prozess.
Ähnliches Problem?
Erzähl uns, was du vorhast, ein kurzes Gespräch klärt, ob sich das rechnet.