 senn-tech
M5 Ultra: die ersten Messwerte für lokale Sprachmodelle
Unser Vergleich vom 6. September endete mit: Gemessen ist der M5 Ultra noch nirgends. Seit dem 21. September gibt es Messwerte. Federico Viticci hat für MacStories vier Tage lang einen M5 Ultra mit 256 GB gegen einen M3 Ultra mit 512 GB gemessen, Alex Ziskind hat beide Maschinen mit denselben Bauten von llama.cpp und MLX gegenübergestellt, Alex Grankin verdichtet die Werte aller Reviews zu einer Generationenleiter. Drei unabhängige Blicke, ein Ergebnis: Das Datenblatt lügt diesmal nicht, und die Zahl, die alle zitieren, gilt nur für die Hälfte der Anfragen.
Die Versuchsanordnung
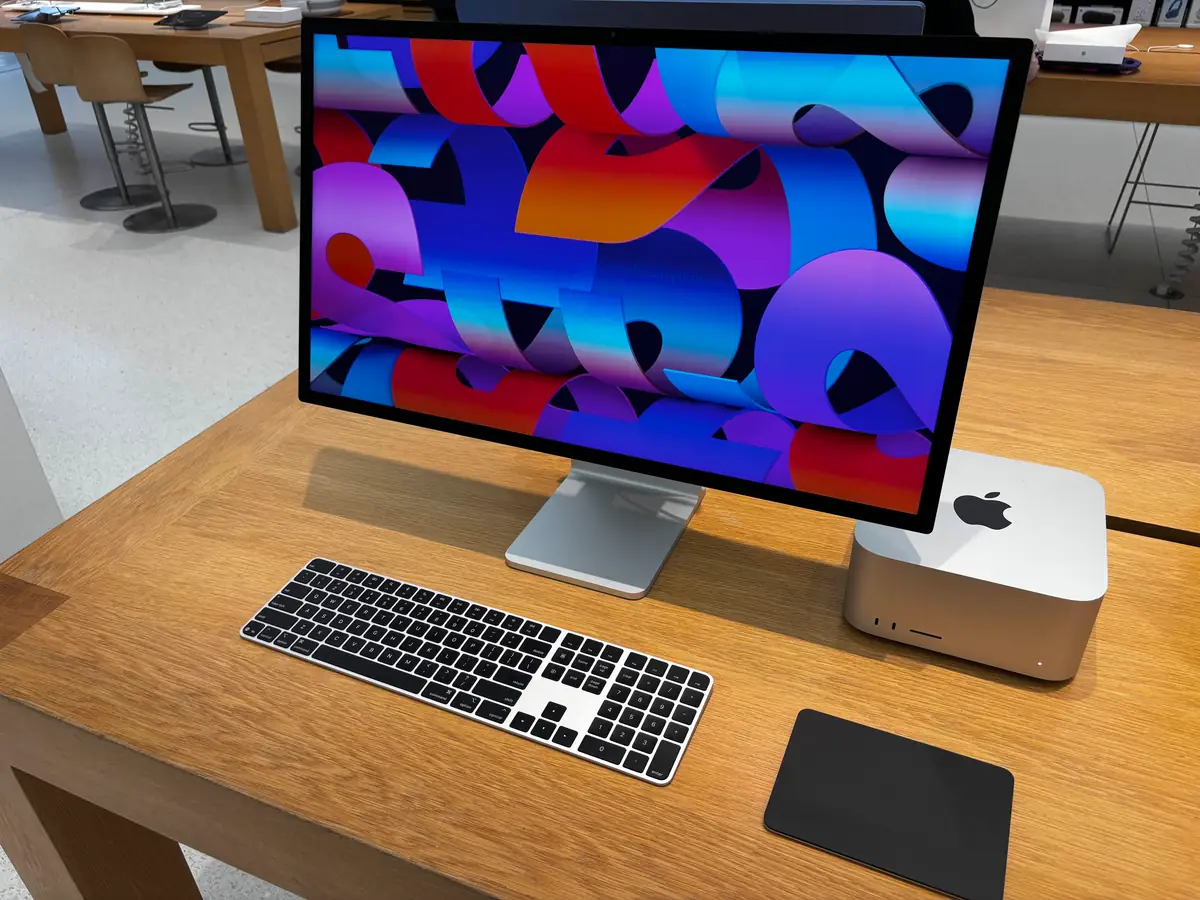
Ziskind fährt die Variante mit 80 GPU-Kernen, 256 GB und 8-TB-SSD für 14.299 US-Dollar, die Basis beginnt bei 5.499. In Europa stehen wir bei 12.429 Euro, die Preistabelle steht im Beitrag von Anfang September. Die 512-GB-Stufe folgt Ende Oktober, Referenz ist ein M3 Ultra mit ausgeworfenen 819 GB/s. Viticci misst auf der Mac-Seite mit oMLX, auf dem Windows-Rechner mit LM Studio und CUDA, Ziskind mit llama.cpp und MLX auf beiden Macs.
Von den beworbenen 1.200 GB/s kommen 1.039 an
Zuerst das Instrument, denn daran hängt die Bewertung. Der STREAM-Test läuft über die CPU und gibt dem M5 Ultra 583,6 GB/s gegen 312,9 auf dem M3 Ultra, ein echter Wert und die falsche Frage, denn Inferenz läuft auf der GPU. Der Mikrobenchmark von der GPU-Seite bringt 1.039 GB/s beim M5 Ultra gegen 724 beim M3 Ultra. Beide erreichen 87 bis 89 Prozent der Werksangabe, der Verlust ist über die Generation identisch, das Verhältnis der Messwerte beträgt 1,44.
Drei Modelle, zwei Physiken
Beim Erzeugen zieht jedes Token alle aktiven Gewichte einmal durch den Speicher, der Durchsatz folgt der Bandbreite. Beim Lesen des Prompts zählt die GPU-Rechenleistung, und dort sitzen im M5 Ultra die Neural Accelerators. Diese zwei Kurven lassen sich jetzt trennen.
| Modell | Bauart | Token/s M3 Ultra | Token/s M5 Ultra | Prefill M3 | Prefill M5 |
|---|---|---|---|---|---|
| DeepSeek V4 Flash, 284 Mrd. | MoE | 37 | 53 | 483 | 1.485 |
| gpt-oss-120B | MoE | 90 | 130 | 1.300 | 3.200 |
| Qwen3.8-27B | dicht | 37 | 54 | 430 | 1.800 |
Die Decode-Spalte liegt auf allen drei Modellen bei Faktor 1,4 bis 1,5, die Prefill-Spalte von 3,1- auf 4,2-fach. Ein Randwert für den Alltag: Nach 64.000 Token im Kontext kosten 32.000 weitere auf dem M3 Ultra 80 Sekunden, auf dem M5 Ultra 56.
Zwischen den Generationen: drei Jahre Stillstand, dann ein Sprung
Alle Reviews messen dieselbe Referenz, Qwen3.8-27B mit 4 Bit. Auf dieser Leiter liegen M1, M2 und M3 Ultra bei je rund 30 Token/s, die Ultra-Stufe hat sich drei Generationen lang kaum bewegt. Der M5 Ultra liegt bei 46 bis 54, im Mittel 48, der M5 Max bei 30, ein M4 Max bei 23, der M6 mini bei 10.
Grankin rechnet die Leiter auf eine Aufgabe, die auf seinem M5 Max 9,2 Minuten und 16.500 Token Antwort kostet: 5,0 Minuten auf der 5090, 5,7 auf dem M5 Ultra, rund 9 auf M3 Ultra und M5 Max, 28 auf dem mini.
Was ein langer Kontext mit dem Tempo macht
Die vierfach bessere Prompt-Verarbeitung ist nur die halbe Geschichte: derselbe Rechner schreibt langsamer, je mehr Kontext er trägt. Viticci und Grankin messen auf Qwen3.8-27B denselben Verlauf: 48 Token/s bei kurzem Prompt, 39 bei 64.000, 32 bei 128.000, 24 bei 256.000.
Der zweite Effekt sitzt im Speicher: Jeder Kontext kostet zusätzlichen RAM, und der ist belegt. GLM 5.3 Flash schreibt auf 256 GB zwar 32 Token/s, passt aber nur bis 128.000 Token Kontext, darüber läuft der Rechner voll. Qwen3.8-Flash-Next schreibt 88 bis 100 Token/s und verträgt jeden Kontext. Es entscheidet die Bauart, nicht allein die Hardware.
Die Vier gilt erst ab viertausend Token
Apple verspricht bis zu 4,5-fache Spitzenleistung gegenüber dem M3 Ultra. Ziskind hat nachgemessen, ab welcher Promptlänge daraus eine Vier wird: bei 350 Token sind es 1,6-fach, bei 1.700 Token 3,4-fach, ab etwa 4.500 Token steht die Vier im Protokoll, an einem echten Prompt aus 14.000 Token misst er 33 Sekunden gegen 8. Viticci misst 150 Prozent mehr Prefill-Durchsatz im Mittel und 245 zu 102 Sekunden bis zum ersten Token hinter einem 256K-Prompt. Grankins Rechnung für einen 80-Seiten-Paste mit 32.000 Token: 19 Sekunden auf dem M5 Ultra, 39 auf dem M5 Max, 77 auf dem M3 Ultra.
llama.cpp spricht die Neural Accelerators jetzt an
Im Video ist das Startlog von llama.cpp zu sehen, einmal pro Maschine. Auf dem M3 Ultra meldet die Laufzeit has_tensor = false, auf dem M5 Ultra has_tensor = true. Das ist der Pfad zu den Matrixeinheiten, der Grund für die Prefill-Sprünge. Unsere Notiz vom September über LM Studio betraf die dort gebündelte Laufzeit, der Fehlerbericht ist offen. Wer kauft, prüft den Build im Verzeichnis und sein Startlog.
Der Sprung kostet Strom
Beim Erzeugen meldet die M5-Stufe rund 45 Watt für GPU plus CPU gegen 36 Watt beim M3 Ultra, gemessen am Paket, nicht an der Steckdose. Im Leerlauf bleibt er mit 8 bis 10 Watt unter dem Vorgänger. Unter dauerhaft voller Auslastung geht die Kurve auf über 400 Watt, der M3 Ultra bleibt bei knapp 200, die Effizienz je Token steigt um gut zwölf Prozent. Dazu kommen hörbare Lüfter und 43 bis 44 Grad Temperatur.
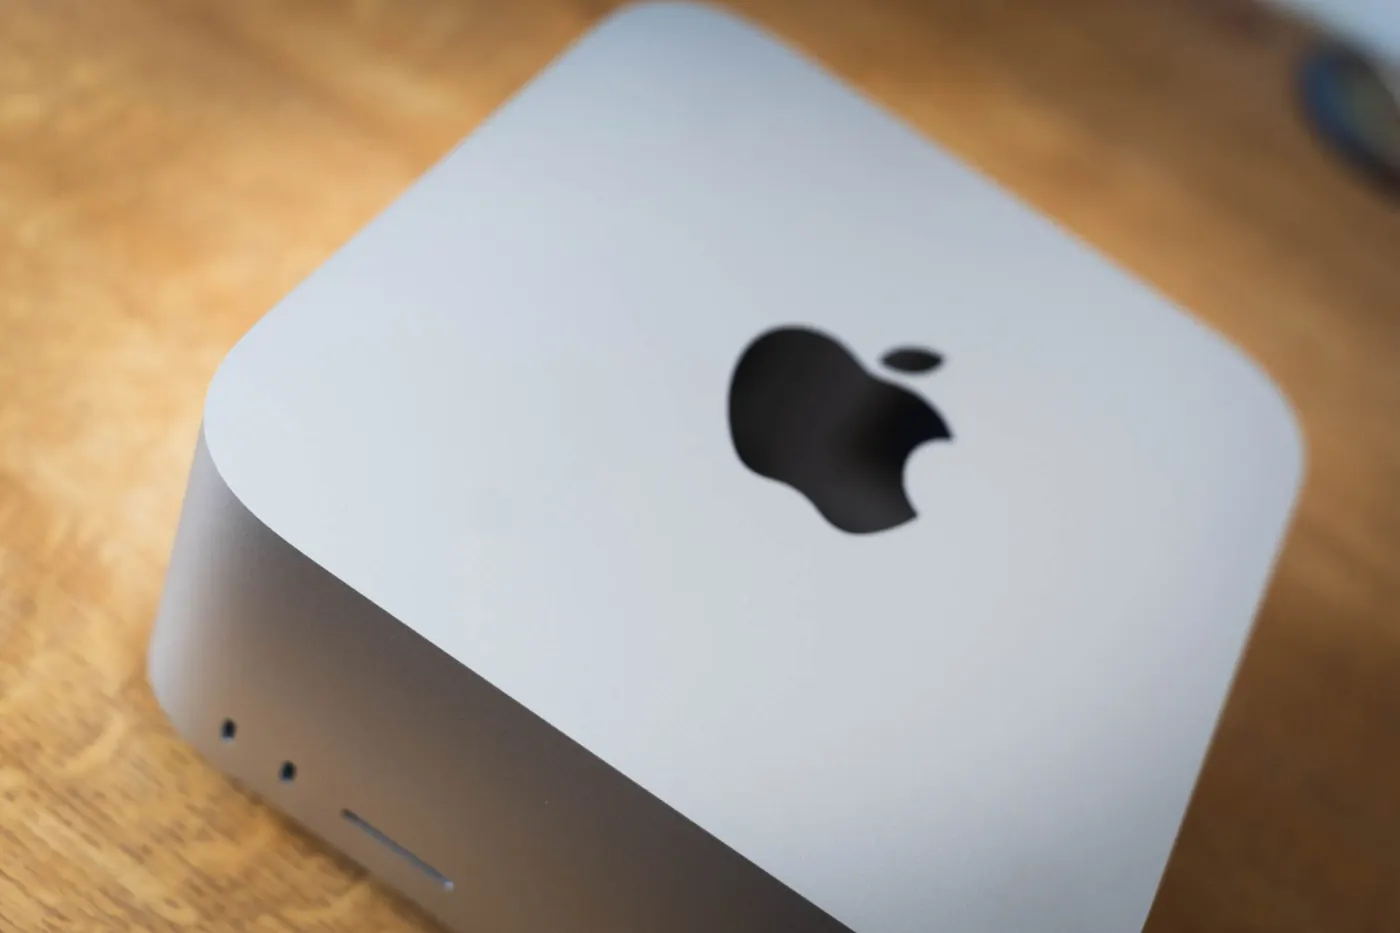
Was unsere 4× RTX 5090 dagegen hält
Viticci hat auf allen drei Welten dasselbe Qwen3.8-27B abgefragt, auf der Karte als GGUF Q4_K_M, auf den Macs als MLX-Bau. Beim 6.000-Token-Prompt liest die 5090 3.031 Token/s und schreibt 59, der M5 Ultra 1.701 und 48, der M3 Ultra 414 und 31. Bei 64.000 Token Kontext schreiben die drei 49,6 zu 38,9 zu 23,5. Die 5090 hält diese Werte aber nur mit 8-Bit-Schlüsselcache in ihren 32 GB; muss sie Schichten über PCIe auslagern, fallen dieselben Läufe auf 4,6 bis 1,5 Token/s. Grankin sieht dieselbe Rangfolge: die Karte beim Lesen etwa doppelt so schnell wie der Mac, der Mac beim Schreiben etwa dreimal so schnell wie ein DGX Spark, der mit 8 bis 9 Token/s bei 128.000 Kontext nicht mehr arbeitet.
Unsere Box ist damit nicht vergleichbar, und das gehört in den Text: Vier RTX 5090 mit Tensorparallelität sind 128 GB VRAM und kein einzelner Stream. Nach vier Tagen Dauerbetrieb mit Qwen3.8-27B unter vLLM stehen wir bei durchschnittlich 96 Token/s über alle gleichzeitigen Anfragen, mit Lastspitzen von rund 16.000 Token/s im Prompt-Durchsatz. Das ist Durchsatz für eine Gruppe, nicht die Antwortzeit eines Schreibtischs. Was die Mac-Maschine stellt, ist Speicher: 256 GB, ohne Auslagern, ohne PCIe-Kante, nahezu unhörbar.
Unsere Sicht
Die Messstrecken geben uns in einem Punkt recht und in einem zweiten Apple: Der Decode-Gewinn ist exakt der Bandbreitengewinn, wer das Datenblatt gelesen hat, wurde hier nicht überrascht. Der eigentliche Sprung sitzt beim Prefill und hängt an einer Bedingung, die in keiner Schlagzeile steht. Wer lokal nur chattet, kauft einen teuren M3 Ultra. Wer Agenten mit langem Kontext auf einer Arbeitsstation fahren will, bekommt erstmals eine Maschine, über die sich rechnen lässt. Offen bleiben die 512-GB-Stufe Ende Oktober und Messwerte jenseits der Einzelperson: acht gleichzeitige Anfragen sollen 134 gegen 75 Token/s ergeben, Viticcis drei gleichzeitige liefern kumuliert 81,5 gegen 39,9. Gekauft wird deshalb nicht, gemessen wird weiter.
Weiterführende Quellen
- Ziskind: M5 Ultra, Apple Wasn't Messing Around, 22.09.2026
- Grankin: M5 Ultra Is Out, 22.09.2026
- Viticci: Mac Studio M5 Ultra Review, MacStories, 21.09.2026
- Außerdem: Tom's Hardware, 9to5Mac, The Verge
- oMLX-Releases
- LM Studio, Issue 2040
- Apple: M6 und M5 Ultra, 25.08.2026
- Fotos: Mac Studio am Display, CC0; Ansicht von oben, CC BY 2.0, Paul Hudson
- Mac Studio, Strix Halo, DGX Spark, 06.09.2026
- Qwen3.8-27B im Eigenbetrieb
- DRAM-Bandbreite auf 4× RTX 5090
- llama.cpp und GGUF


Wie schnell ist der M5 Ultra bei lokalen Sprachmodellen wirklich?+
Gemessen, nicht gerechnet: 53 Token/s beim Erzeugen mit DeepSeek V4 Flash mit 284 Milliarden Parametern, 130 Token/s mit gpt-oss-120B, 54 Token/s mit dem dichten Qwen3.8-27B. Das sind das 1,4- bis 1,5-Fache des M3 Ultra und deckt sich mit der gemessenen Bandbreite von 1.039 gegen 724 GB/s.
Gilt Apples Versprechen der vierfachen Prompt-Verarbeitung?+
Ab etwa 4.500 Token Promptlänge ja, darunter nicht. Bei rund 350 Token sind es 1,6-fach, bei 1.700 Token 3,4-fach, an einem echten 14.000-Token-Code-Prompt 4,1-fach. Wer nur chattet, merkt den Unterschied kaum, wer Agenten mit großem Kontext fährt, sehr deutlich.
Ist der M5 Ultra schneller als eine RTX 5090?+
Auf einer einzelnen Karte nicht. MacStories hat Qwen3.8-27B auf beiden Welten gemessen: die 5090 schreibt 59 Token/s und liest 3.031 Token/s, der M5 Ultra 48 und 1.701. Die 5090 stößt dabei aber an ihre 32 GB VRAM, während der Mac mit 256 GB nie auslagert.
Soll ein Unternehmen die Maschine kaufen?+
Für eine Arbeitsstation mit großem Kontext ist sie erstmals brauchbar, die 256-GB-Konfiguration steht bei 12.429 Euro. Unter Last zieht der Rechner über 400 Watt, die Effizienz pro Token steigt nur um zwölf Prozent. Für einen dienstlich geöffneten Endpoint bleibt unsere Mehrkarten-Box die bessere Rechnung.
Taugt der neue M6 Mac mini für lokale Sprachmodelle?+
Ausgemessen nein. 170 GB/s Speicherbandbreite, maximal 32 GB Arbeitsspeicher und rund 10 Token/s beim Qwen3.8-27B. Eine Aufgabe mit 16.500 Token Antwort, die auf dem M5 Ultra nach 5,7 Minuten fertig ist, läuft dort etwa 28 Minuten.
Was ist besser: 96 GB M5 Ultra oder 128 GB M5 Max?+
Der Ultra, sobald das Modell in 96 GB passt. Er liest den Prompt etwa doppelt so schnell wie der Max und schreibt rund 1,5-fach. Nur wenn ein Modell mehr als 96 GB braucht, entscheidet der Speicher des Max.