 senn-tech
Enterprise-KI-Stack im Eigenbetrieb
Referenzkunde: Eigenbetrieb: die firmeneigene KI-Infrastruktur des Studios
Kundendaten in Texten und Bildern sind neutralisiert.
Vier Hosts, drei Rollen
Fünf Wochen, Host für Host
Die Daten geben die Reihenfolge vor; das ist ein Änderungsprotokoll, kein Countdown. Jeder Eintrag ist eine Entscheidung, die tatsächlich getroffen und gemessen wurde, kein Plan.
Ein einziges großes MoE-Modell, das ein Cron-Job morgens und abends austauschte. Der Umschalter überlebte das Modell, für das er geschrieben war, und versuchte noch Wochen später, es wiederzubeleben.
Mehrere Modelle nacheinander (Qwen3-VL, dann ein dichtes Qwen3.8-27B) lasen Rechnungen und Lieferscheine als Bild, bevor die Pipeline alles über das Gateway schickte.
Qwen3.6-35B-A3B, eine wirklich andere Architektur (MoE statt dicht), als vierte unabhängige Stimme in der Belegpipeline. Vom 28.08. bis 01.09. lief hier kurz auch der Briefing-Bot.
Deterministisches Markdown- und Tabellenparsing für die Ankerspur der Belegpipeline.
Ein deterministischer Transkribierer neben den beiden Sprachmodell-Spuren: Ein Sprachmodell kann eine Ziffer erfinden, ein Transkribierer nicht. Seither tragen Einbettung, Neu-Sortierung, Docling und mocr diese Karte, 15,4 von 16,4 GB belegt bei fast null Last.
Das dichte 27B löst das 122B-MoE ab. Erstmals zeigen alle sieben Altnamen (vision, text, gemma, gemma-4, qwen3.8-27b, thinking, nothink) auf ein einziges Modell.
Qwen3.8-27B-AWQ-INT4 mit turboquant-KV. Eine ganze Karte für einen Telegram-Bot, bewusst getrennt vom LibreChat-Verkehr.
Freigeräumt für ein anderes Projekt. Erste Station auf der Tour des Bots über drei Hosts in drei Wochen.
Ein Sicherheitsnetz, damit thinking und nothink nicht dunkel wurden, während der Hauptserver mit Flash-Next-Tests belegt war.
Community-Feintuning, dynamische FP8-Quantisierung. Gleicher Wert wie die FP8-Basis in der 21er-Testbatterie (18 von 21), besseres Tool-Calling und Sehen, knappere Ausgabe.
Eine neue Architektur, über alle vier Karten per llama.cpp getestet. Allein hervorragend, bei gleichzeitigen Anfragen brach der Durchsatz ein (siehe Zahlen unten). Der Chatverkehr lief für die Dauer des Tests über den Ausweichserver.
Seine AMD-Karte im Kopfknoten wurde ausgebaut. Der Bot läuft wieder hier, auf llama.cpp mit Cold-Fusion-GAIN IQ4_XS und nativem MTP-Kopf.
Die Durchreichung wurde für ein anderes Projekt gebraucht. In diesem Moment verschwand still die vierte unabhängige Stimme der Belegpipeline.
Das GGUF lief die ganze Zeit ohne Bildmodul. Jede Bildanfrage scheiterte still. Eine fehlende Datei, gefunden und behoben.
Die Chat-Lanes ziehen dauerhaft zurück auf den Hauptserver. Der Bot selbst ist geparkt, seine Cron- und Agentenjobs liefen am selben Tag auf dsh um. Die Aufgabe dieser Karte heute: still warten und thinking/nothink auffangen, wenn der Hauptserver Fehler liefert oder zu lange braucht.
Dieselbe neue Modellfamilie, jetzt auf vLLM, wo gleichzeitige Anfragen wirklich gebündelt werden. Ein FP8-Patch am KV-Zwischenspeicher hat die Gleichzeitigkeit bei gleicher Kontextlänge fast verdoppelt.
262.144 Token, dieselbe Grenze wie beim Modell vom 19.08., diesmal bei der neuen Familie und wirklich an ihrem Maximum.
93 ROCm/HIP/HSA-Pakete, 9 amdgpu/libdrm-Pakete, 22 GB frei. Dieser Host trägt heute LibreChat, LiteLLM, den Auto-Router, die Belegerkennung, dsh und rund 15 MCP-Beidienste, aber keine einzige GPU-Last.
Ausgangslage
Eigene KI-Modelle auf eigener Hardware zu betreiben heißt, jede Entscheidung selbst zu treffen, die eine gemietete API einem abnimmt: welches Modell, welcher Kontext, welche Karte, welcher Ausweichweg. Dafür bleiben die Daten im Haus, und niemand sonst entscheidet, wann ein Modell abgeschaltet oder ausgetauscht wird.
Diese Referenz kommt aus dem Eigenbetrieb: die Flotte, die LibreChat, die eigenen Agenten und die interne Dokumentenverarbeitung täglich trägt. Stößt hier eine Karte an ihre Grenze, wissen wir es zuerst und nicht ein Kunde, der gerade wartet.
Das Schwierige daran
Am Anfang stand ein einziges großes Modell, das ein Cron-Job morgens und abends austauschte. Das hielt so lange, bis der Zeitplan das Modell überlebte: Der Umschalter versuchte noch Wochen später, ein längst abgelöstes Modell wiederzubeleben, weil ihn niemand davon in Kenntnis gesetzt hatte.
Eine zweite Karte las Dokumente für die Rechnungsverarbeitung, mit einer eigenen, unabhängigen Modellarchitektur, damit zwei Leser nicht auf derselben Grundlage sitzen und sich gemeinsam irren. Diese Karte war Spezialhardware, die zum Rest der Flotte nicht kompatibel war, und musste für ein anderes Projekt weichen.
Ein dritter Dienst, ein Telegram-Bot für die tägliche Kurzmeldung, zog binnen drei Wochen über drei verschiedene Karten, immer dorthin, wo gerade Kapazität frei war. Auf der letzten lief er fünf Tage lang blind, weil eine einzelne Datei (der Bildmodul für das Sehen) beim Umzug schlicht vergessen wurde. Kein Fehler, keine Warnung, nur eine Antwort, die nie zum Bild passte.
Lösung
Die Flotte trägt heute eine einzige Modellfamilie über alle Chat-Lanes hinweg (Denken an, Denken aus, Agenten-Betrieb, Dokumentensicht) von einem Server mit vier Grafikkarten, statt sieben verschiedener Modellnamen für sieben verschiedene Zwecke.
Fällt der Hauptserver aus oder braucht er zu lange, springt automatisch eine zweite Karte mit derselben Modellfamilie ein: kleinerer Kontext, andere Quantisierung, aber ohne dass ein Nutzer etwas davon merkt.
Die kleinen, ständig gebrauchten Dienste (Einbettung für die Suche, Neu-Sortierung der Treffer, Texterkennung) sitzen zusammen auf einer einzigen kleinen Karte statt verstreut über die Flotte.
Wie es gebaut ist
Ein Gateway ist der einzige Ansprechpartner für jeden Aufrufer: LibreChat, die Agenten, die interne Automatisierung, sogar die CNC-Anlage in der Fertigung. Welche Karte tatsächlich antwortet, ist dahinter verborgen, und genau das macht den Ausweichserver möglich, ohne dass ein Client umgestellt werden müsste.
Der Weg zur heutigen Kontextgröße von 262.144 Token war kein gerader. Ein neues Modell brauchte zunächst einen niedrigeren, ehrlicheren Wert, weil der alte Höchstwert für die neue Architektur nicht mehr galt, ein Fehler, der sonst erst beim ersten abgeschnittenen Gespräch aufgefallen wäre. Ein Patch am Zwischenspeicher der Karten hob die gleichzeitige Kapazität von 3,2 auf 5,9 volle Gespräche an, bevor der Kontext wieder auf sein echtes Maximum stieg.
Eine andere Software für dasselbe neue Modell lieferte im Alleinbetrieb hervorragende Werte und brach bei acht gleichzeitigen Anfragen auf weniger als die Hälfte des Einzeldurchsatzes ein. Die jetzige Lösung sättigt stattdessen bei über 30 gleichzeitigen Gesprächen, statt bei acht zusammenzubrechen. Das allein hat über die Wahl der Serversoftware entschieden.
Bei der Dokumentenverarbeitung stimmen vier unabhängige Leseversuche über jedes Feld ab: zwei Sprachmodelle, zwei deterministische Texterkennungen. Nachdem die Spezialkarte wegfiel, teilen sich zwei dieser vier Stimmen denselben Server. Das ist offen dokumentiert und wird nicht schöngeredet: Es sind heute drei unabhängige Meinungen und nicht vier.
Jede Lane, was dahintersteht, wofür sie da ist
| Lane | Server | Status | Zweck |
|---|---|---|---|
| thinking | main:8000 | primär | Haupt-Chat-Lane, Denken an. LibreChat und alle 29 Agenten. |
| nothink | main:8000 | primär | Dasselbe Modell, Denken aus: sauberes JSON, werkzeuglastige Abläufe. |
| dsh | main:8000 | primär | Gleicher Server wie thinking, eigene Zeile im Kostenlog für Agentenjobs. |
| vision | main:8000 | primär | Alias für Aufrufer, die noch „vision“ verlangen. Ein eigenes Bildmodell gibt es nicht mehr. |
| thinking-cnc | main:8000 | primär | CNC-Runner mit 30 Minuten Timeout; die üblichen 600 s hatten lange Jobs bei 601 s abgebrochen. |
| cnc-nothink | main:8000 | primär | Derselbe Runner, Denken aus, wenn Überlegen die CNC-Aufgabe entgleisen lässt. |
| text(Alias) | → nothink | versteckt | Altname, durchgereicht. |
| auto(Alias) | → thinking | versteckt | Altname, durchgereicht. |
| thinking-fallback / nothink-fallback | standby:8080 | Ausweich | Automatischer Wechsel, wenn der Hauptserver Fehler liefert oder zu lange braucht. Kleinerer Kontext, INT4 statt FP8: Weiterbetrieb, keine Gleichwertigkeit. |
| embed | helper:8010 | primär | RAG und Vektorsuche. |
| rerank | helper:8011 | primär | Neu-Sortierung der RAG-Treffer. |
| mocr | helper:8123 | primär | Deterministische Texterkennung, zugleich vierte Stimme der Belegpipeline. |
| hermes | standby:8080 | geparkt | Der Briefing-Bot, stillgelegt am 03.09.2026, Jobs auf dsh umgezogen. |
| security | standby:8081 | definiert, aus | Enthemmtes Red-Team-Modell, auskommentiert und nicht live. |
Vier Spuren stimmen über jeden Beleg ab
Die Belegerkennung liest Rechnungen und Lieferscheine für den ERP- und TMS-Import. Jede Spur extrahiert für sich, ein Abgleich wählt je Feld den Konsenswert.
3 unabhängige Meinungen statt 4. Bild- und Textspur laufen seit dem Gateway-Wechsel am 19.08.2026 auf denselben Server (nothink auf dem Hauptserver): Ein Sprachmodell liest zweimal, dazu zwei wirklich getrennte deterministische Parser (Docling, dots.mocr).
Keine schnelle Lösung: Der frühere eigene Bildserver (die AMD R9700 mit vision-moe) wurde am 01.09. ausgebaut, sein Softwarestapel am 07.09. entfernt. Echte Vierfach-Unabhängigkeit heißt einen neuen Server aufsetzen und nicht einen Schalter umlegen.
Die zwei Entscheidungen, die die Zahlen getroffen haben
Gleichzeitigkeit auf der Haupt-Lane (Hauptserver)
Größe des KV-Zwischenspeichers als Vielfaches der Volltext-Anfragen, die er gleichzeitig hält
Gestrichelt ist der Wechsel der Modellfamilie, kein Tuning-Schritt; dort darf die Gleichzeitigkeit zurückfallen. Die beiden durchgezogenen Abschnitte sind dieselbe Familie: Der FP8-KV-Patch hat die Gleichzeitigkeit fast verdoppelt, das echte 262k-Maximum hat einen Teil davon wieder gekostet.
Warum die Haupt-Lane auf vLLM gelandet ist
Dasselbe Flash-Next-Modell, zwei Serverprogramme, Token pro Sekunde
llama.cpp war allein schneller und gebündelt langsamer als es selbst: Acht gleichzeitige Ströme ergaben zusammen weniger Durchsatz als einer. vLLM sättigt, statt einzubrechen, und genau deshalb läuft der Hauptserver damit.
Im Betrieb
Ein Wächter-Skript startet gestoppte Dienste automatisch neu, praktisch, bis er ein Modell falsch identifiziert und ein längst abgelöstes wiederbelebt. Die Regel dazu ist inzwischen so einfach wie hart: Ein Dienst gilt nur dann als 'sollte laufen', wenn seine eigene Neustart-Richtlinie das auch sagt.
Der automatische Ausweichweg wird nicht nur konfiguriert, vielmehr regelmäßig scharf geprüft: Der Hauptserver wird kurz lahmgelegt, und es zählt nur, ob der zweite tatsächlich übernimmt und nicht, ob die Konfiguration plausibel aussieht.
Ergebnis
Alle Chat-Lanes laufen heute über eine Modellfamilie mit automatischer Ausfallsicherung, bei 262.144 Token nativer Kontextgrenze: gemessen und nicht behauptet.
Der frühere Kopfknoten der Flotte trägt heute keine einzige Grafikkarte mehr; sein komplettes Spezialtreiber-Softwarepaket wurde entfernt, 22 GB Speicherplatz frei.
Was wir daraus gelernt haben
Bei einem eigenen AI-Stack ist die Hardware die kleinere Aufgabe. Fast jede Störung in den fünf Wochen Umbau war kein Ausfall einer Karte, vielmehr ein Umbau, bei dem etwas liegenblieb. Gewartet wird deshalb nach einer kurzen Prüfliste und nicht nach Erfahrung.
Wir messen jetzt regelmäßig nach, welches Modell hinter welchem Namen tatsächlich läuft. Systematisch gemacht haben wir das erst für diesen Bericht, und das Ergebnis passte nicht zur Konfiguration. Seither gehört die Messung zur Wartung und nicht mehr zum Bericht.
Vier Karten reichen für unseren Alltag. Die Begrenzung ist nicht die Rechenleistung, vielmehr die Wartungszeit, die neben dem Betrieb übrig bleibt. Wer einen eigenen AI-Stack plant, sollte diese Stunden zuerst rechnen, sie entscheiden, ob die Anlage in zwei Jahren noch aktuell ist.
Andere Projekte aus dem Betrieb
Firmen-KI-Portal auf eigenen GPUs
ChatGPT-Komfort im Haus: 5 Modelle, 32 Werkzeuge, ~90 Nutzerkonten. Chats und Dokumente bleiben im Haus.
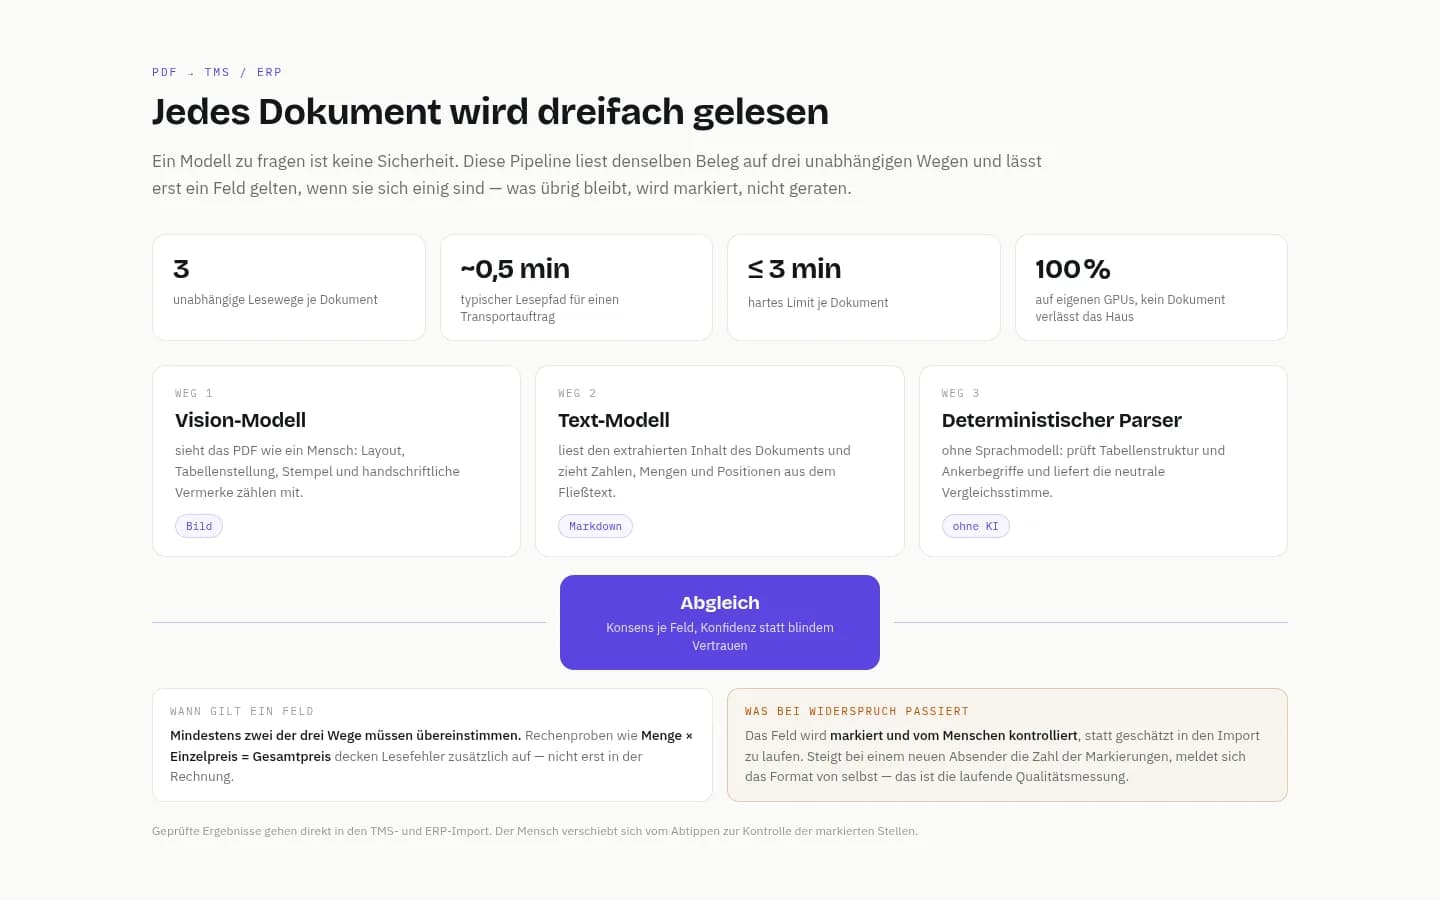
KI-Dokumentenverarbeitung mit Konsens-Prüfung
PDFs dreifach gelesen (Vision-Modell, Text-Modell, Regelwerk) und erst bei Übereinstimmung ins ERP.
Ähnliches Problem?
Erzähl uns, was du vorhast, ein kurzes Gespräch klärt, ob sich das rechnet.