 senn-tech
Firmen-KI-Portal auf eigenen GPUs
Referenzkunde: Logistik- und Handelsgruppe in Tirol · ~100 Mitarbeiter · 4 Standorte
Kundendaten in Texten und Bildern sind neutralisiert.
Ausgangslage
ChatGPT ist im Alltag angekommen — aber Firmendokumente in eine fremde Cloud hochladen? Für ein Unternehmen mit Verantwortung für Kunden- und Personaldaten keine Option. Gleichzeitig wächst der Druck: Wer KI nicht nutzt, arbeitet langsamer als der Wettbewerb.
Gebraucht wurde der Komfort moderner KI-Assistenten — ohne dass ein einziges Dokument das Haus verlässt.
Das Schwierige daran
Datenschutz ist die einfache Begründung für einen eigenen Betrieb. Die schwierige Anforderung ist Brauchbarkeit: Ein Modell im Haus, das spürbar langsamer oder schwächer antwortet als das, was die Leute privat kennen, wird nicht benutzt, sondern umgangen — und dann liegen die Dokumente doch in einer fremden Cloud, nur weiß es diesmal niemand.
Kein Modell ist für alles gut. Ein großes Denkmodell ist stark bei Analysen und unangemessen langsam für eine Übersetzung; ein Bildmodell liest PDFs und taugt nicht als Gesprächspartner. Gebraucht wird also nicht ein Modell, sondern eine Vermittlungsschicht, die je Aufgabe das passende wählt und die Anwendungen davon fernhält, welches gerade dahintersteckt.
Und es braucht eine Antwort auf die Frage, wer was sehen darf. Ein Assistent, der Firmendokumente durchsucht, ist nur so gut wie die Berechtigungen, die er dabei respektiert.
Lösung
Aufgebaut wurde ein firmeneigenes KI-Portal auf eigener Hardware: sechs GPUs, darauf fünf selbst gehostete Modelle — vom großen Denkmodell über ein Vision-Modell für Bilder und PDFs bis zu Embedding und Reranking — hinter einem Gateway mit 15 Modell-Routen.
Das Portal kann mehr als Chat: Wissenssuche über indexierte Firmendokumente mit Quellenangabe, Bild- und PDF-Verständnis, und 32 angebundene Werkzeuge — von der ERP-Abfrage bis zur Websuche — die die Modelle selbstständig nutzen.
Je nach Aufgabe wählt das Gateway das passende Modell. Chats und Dokumente werden ausschließlich auf den eigenen Modellen verarbeitet — nur die optionale Websuche fragt naturgemäß externe Suchmaschinen an.
Wie es gebaut ist
Die Modelle laufen auf eigenen GPU-Servern, jeweils mit einem Inferenz-Dienst davor. Darüber liegt ein Gateway, das benannte Routen anbietet statt Modellnamen: „denken“, „sehen“, „schnell“. Anwendungen kennen nur die Route, und deshalb lässt sich ein Modell darunter austauschen, ohne eine einzige Anwendung anzufassen. Genau das ist seit dem Aufbau mehrfach passiert.
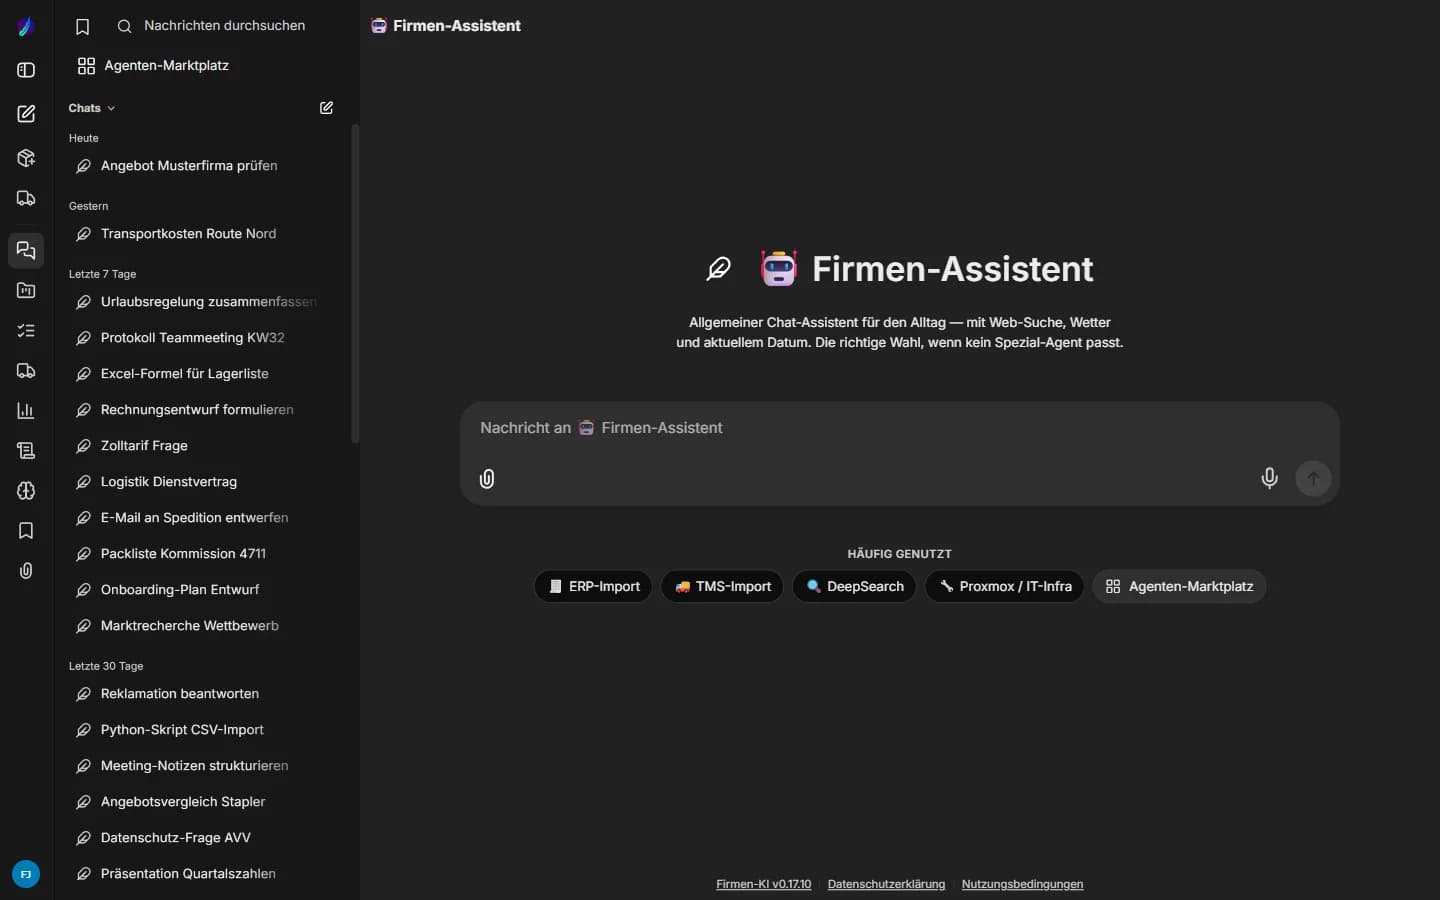
Das Portal selbst ist die Oberfläche: Chat, Wissenssuche über indexierte Firmendokumente mit Quellenangabe, Bild- und PDF-Verständnis. Angebunden sind 32 Werkzeuge, die die Modelle selbstständig aufrufen, von der ERP-Abfrage bis zur Websuche.
Die Anmeldung läuft über den zentralen Firmen-Login, nicht über eigene Konten im Portal. Wer das Unternehmen verlässt, verliert den Zugang an einer Stelle. Nicht an fünf.
Jede Anfrage wird am Gateway protokolliert und mengenmäßig erfasst. Das ist keine Überwachung der Mitarbeiter, sondern die Voraussetzung dafür, Kosten und Auslastung überhaupt beurteilen zu können und zu erkennen, wenn eine Anwendung im Leerlauf Anfragen produziert, für die niemand je eine Antwort liest.
Im Betrieb
Die GPUs sind eine begrenzte Ressource und werden entsprechend eingeteilt. Ein Modell wird zeitgesteuert getauscht, je nachdem, was tagsüber und was nachts gebraucht wird; für die Anwendungen bleibt der Routenname derselbe.
Beobachtet werden nicht nur Verfügbarkeit und Antwortzeiten, sondern auch das Verhalten. Antwortet eine Route plötzlich auffällig schnell, ist das selten ein Fortschritt. Meistens antwortet gerade etwas anderes als gedacht.
Aktualisierungen laufen über ein Wartungsskript, das den ganzen Stack geordnet durchstartet und danach prüft, ob jede Route wieder erreichbar ist — denn ein Teilstart, der die Hälfte der Routen still stehen lässt, ist der unangenehmste aller Zustände: Er sieht aus wie Betrieb.
Ergebnis
Rund 90 Mitarbeiter haben heute KI-Zugang am eigenen Arbeitsplatz — DSGVO-sauber und ohne Cloud-Abo pro Kopf.
Die Kostenkontrolle läuft mit: Jede Anfrage wird intern geroutet und gemessen, statt extern abgerechnet.
Was wir daraus gelernt haben
Das Gateway antwortete auf einen frei erfundenen Modellnamen mit einer gültigen Antwort statt mit einem Fehler. Ein Tippfehler in einer Konfiguration lief damit unbemerkt auf eine andere Route als beabsichtigt, und niemand konnte es sehen, weil ja Antworten kamen. Seit dem Befund gehört ein Test dazu, der prüft, dass ein unbekannter Name auch wirklich scheitert. Das Ausbleiben eines Fehlers ist kein Beweis.
Zwei nächtliche Auswertungen hörten ohne erkennbaren Grund auf zu liefern. Die Ursache stand nicht im Code. Sie stand im Kalender: Das Modell hinter der Route wird zu festen Zeiten getauscht, in diesem Fenster ist sie einige Minuten lang nicht erreichbar, und beide Jobs starteten exakt zur Wechselminute. Seither kennen die Zeitpläne die Wechselfenster.
Beide Fälle haben dieselbe Form, und sie ist typisch für KI-Infrastruktur: Sie scheitert selten am Modell. Sie scheitert dort, wo etwas leise antwortet, statt laut zu scheitern — und das ist deutlich schwerer zu finden als ein Absturz.
 1 von 3
Startansicht: ein Assistent für den Alltag, die Spezial-Agenten einen Klick entfernt (Inhalte pseudonymisiert).
Ähnliches Problem?
Erzähl uns, was du vorhast — ein kurzes Gespräch klärt, ob sich das rechnet.